跳到主要内容
BIMANUAL菜单English

长期指南

机器人如何完成操作?从感知、规划到控制

机器人操作是通过与物体和环境进行有目的的物理交互来完成任务。本文以插销插入为贯穿示例,解释任务相关状态、抓取、规划、接触、控制、反馈,以及学习方法和真实部署证据之间的关系。

发布于
2026年9月15日

核心要点

  • 机器人操作描述的是物理任务和系统问题;它的范围大于抓取,也不等同于机器人学习或 VLA。
  • 机器人需要估计与任务相关的物体、自身状态、接触状态和不确定性;不存在适用于所有任务的固定传感器清单。
  • 任务规划、接触/抓取选择、运动规划、轨迹生成与控制回答不同问题,在不同系统中可以整合或交错进行。
  • 接触、摩擦、柔顺性、遮挡和时序会让插入等接触丰富型任务对小误差非常敏感;视觉、力和触觉反馈既能暴露不确定性,也能帮助系统应对不确定性。
  • 抓取成功或基准成绩不等于完整任务成功,更不等于持续部署证据。

引言

机器人操作关注的是:机器人如何通过有目的的物理交互改变或维持物体,或改变环境的一部分。夹爪可能已经成功闭合,却仍然没有对准孔位;局部动作与任务结果之间的差距,正是本文要解释的系统问题。

这是“模型如何进入物理行动”这一 Physical AI 核心问题 的具体化。机器人需要估计真正重要的状态,选择交互方式,在受约束的工作空间中运动,并根据接触暴露的信息作出响应。感知、规划、控制和学习可以是模块化、学习得到、混合式或交错的;常见的分解只是有用的词汇,不是强制流水线。

本文只使用一个贯穿示例——插销插入。这个例子足以说明机器人操作大于抓取、接触如何改变问题,以及实验室结果为什么只属于某一种证据。

机器人操作是什么意思?

有目的的物理交互

机器人操作是通过有目的的物理交互改变或维持物体或环境状态。目的可以是放置、推动、滑动、插入、折叠、旋转或使用工具。这些是具有代表性的任务族,并不意味着同一台机器人或同一个夹具能够完成全部任务。

操作与移动相关,但回答不同问题

移动主要改变机器人的自身姿态,而操作主要通过接触改变物体或环境。移动操作机器人可以同时完成两者,因此这是一种功能上的区分,而不是硬件类别的切分。

相关概念

抓取是机器人操作中重要的抓取式子问题,但不等同于机器人操作。运动规划可以生成无碰撞路径,却未必建立有用的物体接触。机器人学习关注能力如何获得或改进,而机器人操作指向物理任务和系统目标。VLA 可以是一类根据视觉和语言条件生成动作的策略,但不是完整的机器人操作系统。

一个贯穿示例:插销插入

设想机器人要把插销插入接收孔。一次成功尝试必须让插销与夹具达到合适的相对关系,建立有用接触,在力和摩擦变化时维持这种接触,并满足任务层面的成功条件,例如插销最终就位。具体成功判据取决于任务和评测协议。

这个例子不是控制器调参教程,而是一个紧凑的观察窗口:机器人能看到什么,如何选择抓取和接近方式,如何根据几何约束规划运动,当接触不同于估计时如何响应,以及如何定义成功。

机器人需要什么状态?

观测不等于任务相关状态

相机画面是观测,不会自动成为行动所需的状态。机器人操作系统需要维护关于机器人、物体、环境、接触变量和不确定性的任务相关估计或信念。这个表示可以是显式的、潜在的或学习得到的,并不要求完整的世界模型。

视觉、本体感觉、力与触觉

根据任务不同,有用输入可能包括物体检测或分割、深度或三维几何、位姿、本体感觉(proprioception)、力/力矩感知(force-torque sensing)和触觉感知。这些模态彼此互补:它们在可见性、局部性、噪声和时序上各有不同。不存在适用于所有机器人操作问题的固定传感器清单。

抓取只是机器人操作的一部分

抓取可以建立什么

抓取可以建立有用的接触几何关系,并在移动物体时提供支撑。抓取分析可能使用力闭合(force closure,即在特定假设下抵抗一组外部力/力矩)和形闭合(form closure,即通过几何约束限制运动)等概念。它们描述的是接触安排的分析性质,并不保证之后的任务一定成功。

抓取不能保证什么

稳定抓取本身不能保证对准、插入、放置、避免碰撞或完整任务成功。插销可能被牢牢握住,却仍以错误姿态接近孔位,遇到未建模的接触,或无法满足任务判据。
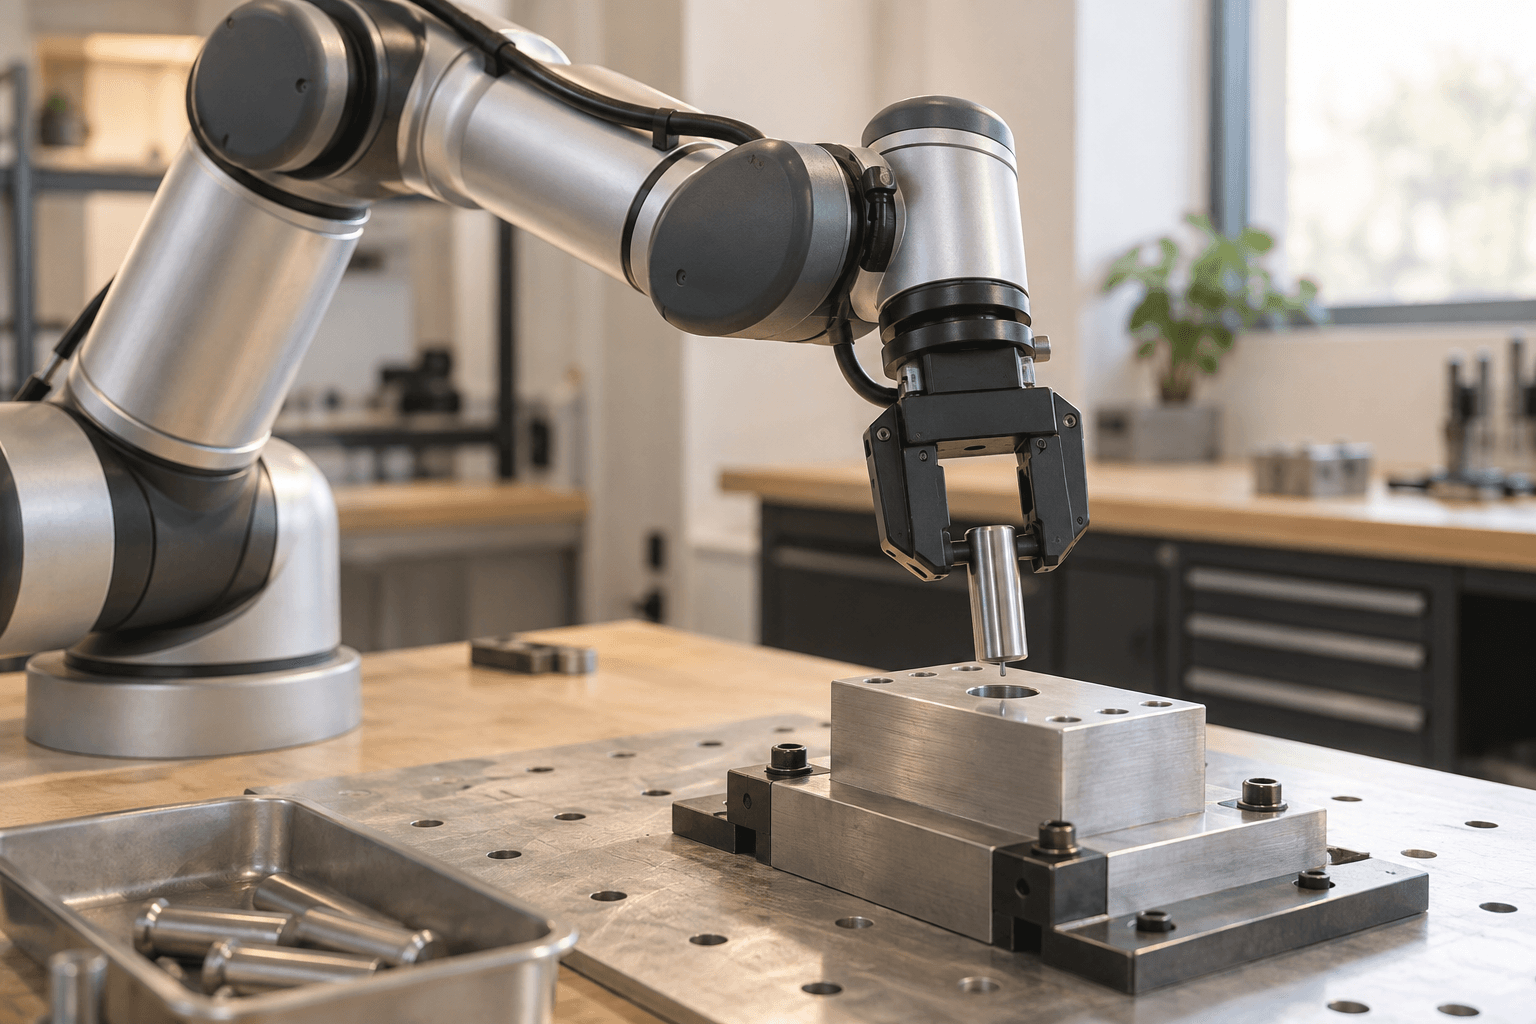
BIMANUAL / 机器人操作机器人操作是持续交互,而不只是抓取
一台机器人夹持着类似插销的物体,靠近工作台上受约束的目标夹具,呈现机器人、物体与环境之间持续的接触关系。

机器人操作包含改变物体或环境所需的持续物理交互。抓取只是其中一个动作原语;任务能否完成,还取决于机器人如何对齐、接触、借助支撑面,并根据周围环境作出响应。

规划动作与运动

任务、接触、运动与轨迹规划

任务规划回答要追求什么目标或子任务;抓取或接触规划回答如何建立并使用物理交互;运动规划回答几何和运动学上是否可行;轨迹生成则进一步处理时序与平滑性。这些问题可以组合、分开或反复处理,不存在固定的“感知 → 规划 → 控制”顺序。

不确定性下的重新规划

当物体位姿、接触位置或碰撞余量与估计不同时,系统可以更新状态估计,选择另一种接触,改变接近方式或重新规划运动。重新规划是一种应对不确定性的策略,不承诺每次失败都能被修复。

为什么接触会改变问题

摩擦、柔顺性、公差与隐藏的接触模式

插入任务不只是自由空间运动。表面接触时,摩擦、间隙、柔顺性、遮挡、时序和未建模动力学都可能改变结果。位姿或时序上的小误差,可能让插销从滑入变成卡住,也可能让有用接触变成不稳定接触。

接触既是扰动,也是信息

接触会扰动原本的运动计划,但也可能揭示任务信息。力和触觉读数可以暴露表面、碰撞或约束变化。这也是 身体与环境的交互 为什么重要:物理响应本身是系统可用的证据,同时它仍然局部、有噪声,不能被夸大为解决全部不确定性的办法。

控制、柔顺性与反馈

从动作参考到执行器行为

控制器把更高层的运动或力参考转换为执行器行为,同时遵守动力学、限制条件和反馈。位置、速度、力矩、阻抗、力控制、操作空间控制(operational-space control)以及混合位置/力控制,是不同的控制形式或接口;它们不是一条通向“更先进”的统一阶梯。

为什么插入时柔顺性可能有帮助

柔顺性会改变机器人受到环境反作用时的响应方式。阻抗控制或力相关控制可以让小的位姿误差产生受约束的交互响应,而不是刚性碰撞。收益取决于机器人、感知、控制器设计和接触条件;柔顺性不是插入成功的保证。

反馈可以改变计划

反馈可能更新状态估计,改变运动或接触选择,或改变控制器响应。在插销任务中,力的瞬态变化可能说明当前对准不正确;下一次响应可以是放慢接近、调整姿态或重新尝试。这里重要的是闭环交互关系,而不是固定的方框顺序。
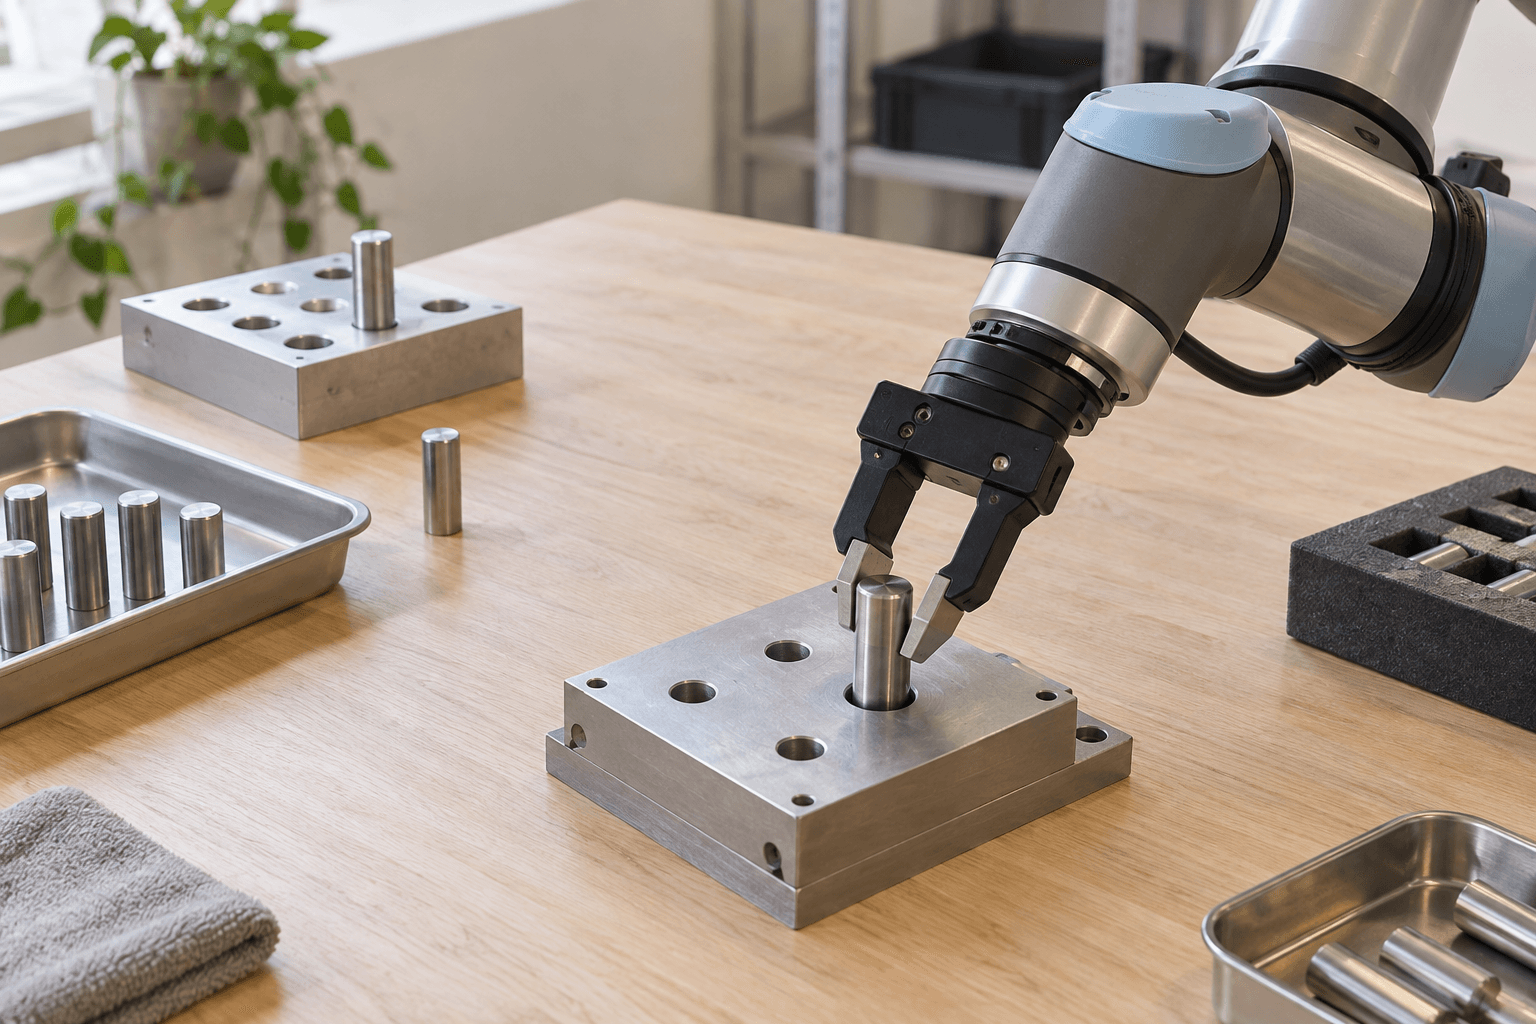
BIMANUAL / 机器人操作机器人操作中的交互闭环
一台机器人在物理工作空间中与物体和夹具交互,场景中可辨认出任务相关状态、运动,以及接触反馈区域。

机器人操作会把任务相关状态、动作与运动、接触与反馈置于持续的物理关系中。反馈可能改变机器人对状态的估计、运动方式或对接触的响应;不同系统可以用不同方式组合这些功能。

这些是相互作用的功能,而不是一套必然遵循的技术顺序。不同系统可以将它们分开、组合,或用学习方法实现。

  1. 01任务相关状态与当前任务有关的物体、目标、接触线索和不确定性。
  2. 02动作与运动在当前工作空间中选择并产生物理运动。
  3. 03接触与反馈交互可以暴露不确定性,并改变下一次响应。

机器人学习与 VLA 在哪里参与

学习可以进入机器人操作系统的不同位置

学习可以用于感知、抓取提议、动力学估计、策略或控制。因而,机器人如何获得一项能力 是相关但不同的问题:机器人学习描述获得或改进行为的方法,而机器人操作描述物理目标和约束。

机器人操作与机器人学习

学习得到的策略可以被放入机器人操作系统,机器人操作任务也可以几乎不使用学习组件。训练成功不等于可靠执行,能够控制机器人也不能说明策略是如何学习得到的。区分这两个范围,可以避免把“机器人操作”写成学习算法综述。

机器人操作与 VLA

VLA 模型可以根据视觉和语言输入条件化某种动作表示,但系统仍然需要状态估计、接触处理、运动约束、底层控制、安全逻辑和评测。这里要问的是 VLA 策略可以在哪里参与机器人操作,而不是 VLA 是否等于完整的机器人操作系统。

如何评估机器人操作——为什么实验室成功不等于实际部署

不同指标回答不同问题

抓取成功率、位姿误差、插入判据、碰撞次数和完成率,分别衡量问题的不同部分。在解释结果前,需要说明任务、物体集合、机器人、时间跨度、人工干预策略和成功定义。

证据类别

证据可以来自仿真、基准测试、受控硬件实验、重复硬件试验、试点或持续运行。每一类证据回答不同问题。仿真基准可以暴露任务多样性,实体机器人基准可以暴露接触与硬件差异;它们都不是部署证书。

为什么实验室成功不等于实际部署

一次成功演示或基准结果,是特定报告设置下的有限证据,不能直接证明系统在不同环境、物体、维护条件或运行策略下都可靠。因此,为什么机器人操作必须超越仿真进行测试,与某个控制器或策略在一次实验中有效,是两个不同的问题。

局限与开放问题

泛化、接触感知与安全恢复

开放问题包括:如何在不过度声称完整状态的前提下表示不确定性,如何在可见性较差时感知接触,如何适应变化的摩擦和公差,以及预期交互失败时如何安全恢复。这些挑战出现在机械臂、机械手、移动操作机器人和其他具身形态中;人形外形并不是必要条件。

灵巧性和双臂协调可以作为边界例子,但不能自动证明通用机器人操作能力。更多关节或一次成功演示,本身都不足以建立稳健、可重复的任务表现。

结论

机器人操作是对有目的物理交互的研究与工程实践。插销插入说明了关键边界:感知必须与任务相关,抓取只是一个子问题,规划和控制回答不同问题,而接触既带来不确定性也提供信息。学习和 VLA 可以在不同位置发挥作用,却不会消除对物理证据的需要。最稳妥的结论是:机器人操作主张有多强,取决于任务定义、反馈条件以及背后的部署证据。

相关主题

来源

  1. DROID: A Large-Scale In-The-Wild Robot Manipulation DatasetKhazatsky et al. · 第一手来源 · RM-C026

    Research Pack RM-30; Supports the dataset/evidence boundary; diversity of demonstrations is not proof of policy generalization or deployment. [Claims: RM-C026]

  2. FurnitureBench: Reproducible Real-World Benchmark for Long-Horizon Complex ManipulationMinho Heo, Youngwoon Lee, Doohyun Lee, and Joseph J. Lim · 第一手来源 · RM-C026

    Research Pack RM-29; Supports the real-world benchmark evidence category; task and protocol remain bounded. [Claims: RM-C026]

  3. RLBench: The Robot Learning Benchmark & Learning EnvironmentStephen James, Zicong Ma, David Rovick Arrojo, and Andrew J. Davison · 第一手来源 · RM-C026

    Research Pack RM-28; Supports the simulation-benchmark evidence category; benchmark success does not establish real-world reliability. [Claims: RM-C026]

  4. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic ControlGoogle DeepMind · 第一手来源 · RM-C022

    Research Pack RM-26; Supports the scoped VLA policy-family boundary; RT-2 setup and action representation are source-specific. [Claims: RM-C022]

  5. Dex-Net 2.0: Deep Learning to Plan Robust Grasps with Synthetic Point Clouds and Analytic Grasp MetricsJeffrey Mahler et al. · 第一手来源 · RM-C005

    Research Pack RM-17; Supports a bounded learned/synthetic grasp example; reported grasp evaluation is not whole-task deployment evidence. [Claims: RM-C005]

  6. Making Sense of Vision and Touch: Learning Multimodal Representations for Contact-Rich TasksMichelle A. Lee et al. · 第一手来源 · RM-C018

    Research Pack RM-15; Supports visual/tactile contact evidence and the bounded claim that contact is both disturbance and information. [Claims: RM-C008, RM-C009, RM-C017, RM-C018]

  7. Robotic Tactile Perception of Object Properties: A ReviewShan Luo, Joao Bimbo, Ravinder Dahiya, and Hongbin Liu · 第二手来源 · RM-C008

    Research Pack RM-14; Supports tactile sensing as one possible task-relevant modality; coverage is task dependent. [Claims: RM-C008, RM-C018]

  8. A Survey of Robot Manipulation in ContactMarkku Suomalainen, Yiannis Karayiannidis, and Ville Kyrki · 第二手来源 · RM-C017

    Research Pack RM-13; Supports contact-rich difficulty and the role of friction, compliance, contact modes, and uncertainty. [Claims: RM-C017, RM-C018, RM-C021]

  9. Integrated Task and Motion Planning in Belief SpaceLeslie Pack Kaelbling and Tomás Lozano-Pérez · 第一手来源 · RM-C009

    Research Pack RM-11; Supports task-relevant belief/state estimation and planning under uncertainty. [Claims: RM-C009, RM-C011]

  10. Hybrid Position/Force Control of ManipulatorsMarc H. Raibert and John J. Craig · 第一手来源 · RM-C016

    Research Pack RM-10; Supports the bounded explanation of hybrid position/force feedback during interaction. [Claims: RM-C016]

  11. Impedance Control: An Approach to Manipulation, Part I—TheoryNeville Hogan · 第一手来源 · RM-C016

    Research Pack RM-09; Supports the bounded explanation of impedance and interaction response; controller behavior depends on sensing and conditions. [Claims: RM-C016]

  12. Modern Robotics: Mechanics, Planning, and ControlKevin M. Lynch and Frank C. Park · 第二手来源 · RM-C011

    Research Pack RM-07; Supports the conceptual separation of task, contact/grasp, motion, trajectory, and control questions; implementations may combine them. [Claims: RM-C002, RM-C004, RM-C008, RM-C011, RM-C013]

  13. Planning Optimal GraspsCarlo Ferrari and John Canny · 第一手来源 · RM-C005

    Research Pack RM-04; Supports scoped grasp-quality and wrench/contact metrics; these metrics do not equal whole-task success. [Claims: RM-C005]

  14. Robotic Grasping and Contact: A ReviewAntonio Bicchi and Vijay Kumar · 第二手来源 · RM-C004

    Research Pack RM-03; Supports grasping/contact vocabulary and the boundary that grasping is a subproblem, not the whole task. [Claims: RM-C004, RM-C005]

  15. Mechanics and Planning of Manipulator Pushing OperationsMatthew T. Mason · 第一手来源 · RM-C002

    Research Pack RM-02; Supports representative contact-mediated manipulation primitives and the boundary between free-space motion and useful contact. [Claims: RM-C002, RM-C013, RM-C017]

  16. Toward Robotic ManipulationMatthew T. Mason · 第二手来源 · RM-C001

    Research Pack RM-01; Lead definition and scope; supports the bounded definition of purposeful physical interaction and the distinction from grasping. [Claims: RM-C001, RM-C002, RM-C004, RM-C021]

继续阅读

长期指南什么是 Sim2Real?机器人如何从仿真走向现实

Sim2Real 指将机器人在仿真环境中获得的能力迁移到真实机器人,并用现实世界的测试验证其可靠性的一组方法。本文解释现实差距、主要迁移策略,以及为什么仿真成功不等于部署成功。

长期指南机器人如何学习?从示范学习、强化学习到 Sim2Real

机器人学习是机器人通过数据、示范、环境交互或仿真获得并改进能力的方法集合。本文解释行为克隆、强化学习、机器人数据与 Sim2Real 的作用,同时区分学习策略、规划器、控制器和真实部署证据。

长期指南什么是具身智能?身体、环境与行动如何共同塑造智能

具身智能不是一个单独的模型名称,而是一种系统视角:智能体的身体与环境会共同影响它能感知什么、如何学习,以及如何行动。本文定义这一概念,并厘清它与相邻 AI 术语的边界。

长期指南什么是 VLA?Vision-Language-Action 模型如何让机器人理解并执行指令

解释 Vision-Language-Action 模型如何连接语言、视觉与机器人行为,以及它在完整机器人控制架构中的位置。

长期指南从 LLM 到机器人动作:VLM、VLA、世界模型、强化学习、Sim2Real 和机器人控制到底是什么关系?

用一个“把红色杯子放进盒子”的任务,拆开 LLM、VLM、VLA、世界模型、模仿学习、强化学习、仿真、Sim2Real、规划、策略与控制在 Physical AI 中的分工。