长期指南
什么是 Sim2Real?机器人如何从仿真走向现实
Sim2Real 指将机器人在仿真环境中获得的能力迁移到真实机器人,并用现实世界的测试验证其可靠性的一组方法。本文解释现实差距、主要迁移策略,以及为什么仿真成功不等于部署成功。
- 发布于
- 2026年9月14日
核心要点
- Sim2Real 是迁移与验证问题,而不是单一算法。
- 外观、动力学、接触、传感、时序和 embodiment 都可能造成仿真与现实的差距。
- 域随机化、动力学随机化、系统辨识、自适应以及混合仿真—真实数据分别应对不同问题。
- 仿真基准与真实机器人评估回答的是不同问题。
- 无论是学习策略、VLA 模型还是控制器,都需要针对硬件的安全措施和部署证据。
引言
在仿真器中成功的策略,并不自动意味着它已经学会如何操作真实机器人。Sim2Real 指的是这样一个迁移与验证问题:当模型、策略、表征、控制器或工作流从仿真源域走向物理目标系统时,如何理解并管理两者之间的差异。
这个问题位于更完整的 Physical AI 技术栈之内,连接感知、行动、身体、硬件与运行条件。本文聚焦仿真到现实的边界,而不是某一种模型家族。
什么是 Sim2Real?
Sim2Real 是将机器人能力从建模环境迁移到真实环境,并用现实证据进行验证的一组方法。被迁移的对象可以是学习策略、控制器、表征、技能、模型参数或经过校准的工作流。它取决于具体任务与身体形态,不是单一算法。
源域与目标域
源域是进行训练、调试或测试的仿真或其他建模环境;目标域则是使用真实传感器、执行器、物体、时序和环境变化的特定机器人。可靠的表述应同时说明两个域以及要迁移的任务。
Sim2Real 不是什么
Sim2Real 不是仿真本身,也不是机器人学习或强化学习的同义词。仿真器是工具或环境,而不是策略已经在硬件上工作的证据。数字孪生可能持续连接某个具体物理资产,用于监测、预测或决策支持;Sim2Real 并不要求这些属性。
为什么仿真与现实存在差距?
视觉与传感差异
纹理、光照、相机模型、遮挡、标定、噪声、曝光和缺失观测,都可能在渲染场景与真实传感器之间不同。视觉相似只是迁移的一部分;即使画面看起来逼真,策略仍可能失败。
动力学、接触与执行器
质量、摩擦、柔顺性、回差、执行器限制、延迟、碰撞和接触转换都难以被完全建模。当物体发生形变、滑移,或以略有不同的角度接触表面时,接触密集型行为可能改变。增加仿真细节本身不会消除不确定性。
任务、时序与身体形态差异
物体摆放、工作空间、重置条件、时序假设、身体形态和动作接口都可能改变目标分布。在一台机器人、一个任务上的结果,不应被表述为适用于所有身体或环境的证据。
因此,现实差距是一组取决于任务的差异,而不是一个普适的单一指标。关键维度取决于机器人如何感知、如何行动,以及什么被定义为成功。
为什么要在仿真中进行机器人学习?
相较于收集每一次真实尝试,仿真可以提供可扩展、可重复的试验,更快的迭代,并支持并行 rollout、参数扫描和更安全的探索。它也能让少见失败更容易被复现和比较。
这些优势降低了迭代成本,却不能证明传感、硬件可靠性、安全性或现实任务表现。仿真器、任务模型、传感器模型、动力学与评估协议,共同决定仿真结果究竟说明什么。
主要 Sim2Real 迁移策略
域随机化
域随机化在训练期间改变视觉或环境参数,让学习者遇到一组条件,而不是一个被精心调整的场景。它是否有效,取决于随机化条件是否覆盖目标环境。它是一种鲁棒性策略,而不是保证。
动力学随机化
动力学随机化改变质量、摩擦、阻尼、电机强度或延迟等物理参数。当随机范围覆盖相关行为时,它可以改善特定控制任务的迁移;但结果仍受所报告的机器人、任务与协议约束。
系统辨识与标定
系统辨识从硬件观测中估计机器人或环境参数,再用这些估计来对齐模型与物理系统。标定可以减少执行器、传感器、时序或接触方面的偏差,但未建模效应和变化环境仍然存在。
自适应与表征迁移
微调、残差模型、特征对齐、在线自适应和保守的策略更新,都可以利用目标域证据来管理差异。自适应可能需要真实数据,也可能引入新的失败模式,因此应明确安全与回滚边界。
混合仿真与真实数据
真实数据可以补充仿真,尤其是传感特征、接触行为和身体形态的影响。少量但精心选择的真实数据,可能回答大规模仿真数据无法回答的问题。数据更多并不自动意味着泛化更强。
模仿学习、强化学习与通用策略处于什么位置?
模仿学习
示范可以来自仿真、远程操作或真实硬件。学习者仍可能访问示范中没有覆盖的状态,因此分布偏移依然重要。DAgger 等交互式重标注方法是其中一种应对方式,并不是所有系统的必选步骤。
强化学习
强化学习可以利用仿真进行大规模探索,但较高的仿真奖励可能只反映仿真器特有的捷径。奖励设计、探索过程与目标域评估,仍然是不同问题。
通用策略与 VLA 模型
通用策略和视觉—语言—行动模型可以成为被迁移的对象、表征来源,或混合仿真与真实数据的系统组成部分。它们是围绕机器人行动的模型或策略选择,并不自动等于 Sim2Real 方法。
关于能力如何获得的更宽问题,可以参阅机器人如何学习?。机器人学习是更大的方法领域,包含仿真、模仿、强化、离线、基于模型和混合方法。
仿真成功与真实世界评估
仿真成功只是仿真证据。基准测试、受控硬件试验、变化环境中的重复评估、有边界的试点,以及持续生产运行,回答的是不同问题,应当分别报告。
证据层级
可以用一个用于报告的证据层级来描述结果,但不应暗示所有项目都必须到达最后一层:仅仿真结果、受控硬件测试、重复的真实世界评估、有边界的试点,或包含干预、安全、失败与时间范围信息的持续运行。
可信的迁移报告应说明机器人、任务、初始条件、环境变化、试验次数与类型、人工干预规则、失败处理方式,以及没有测试的边界。证据的强度始终受这些条件约束。
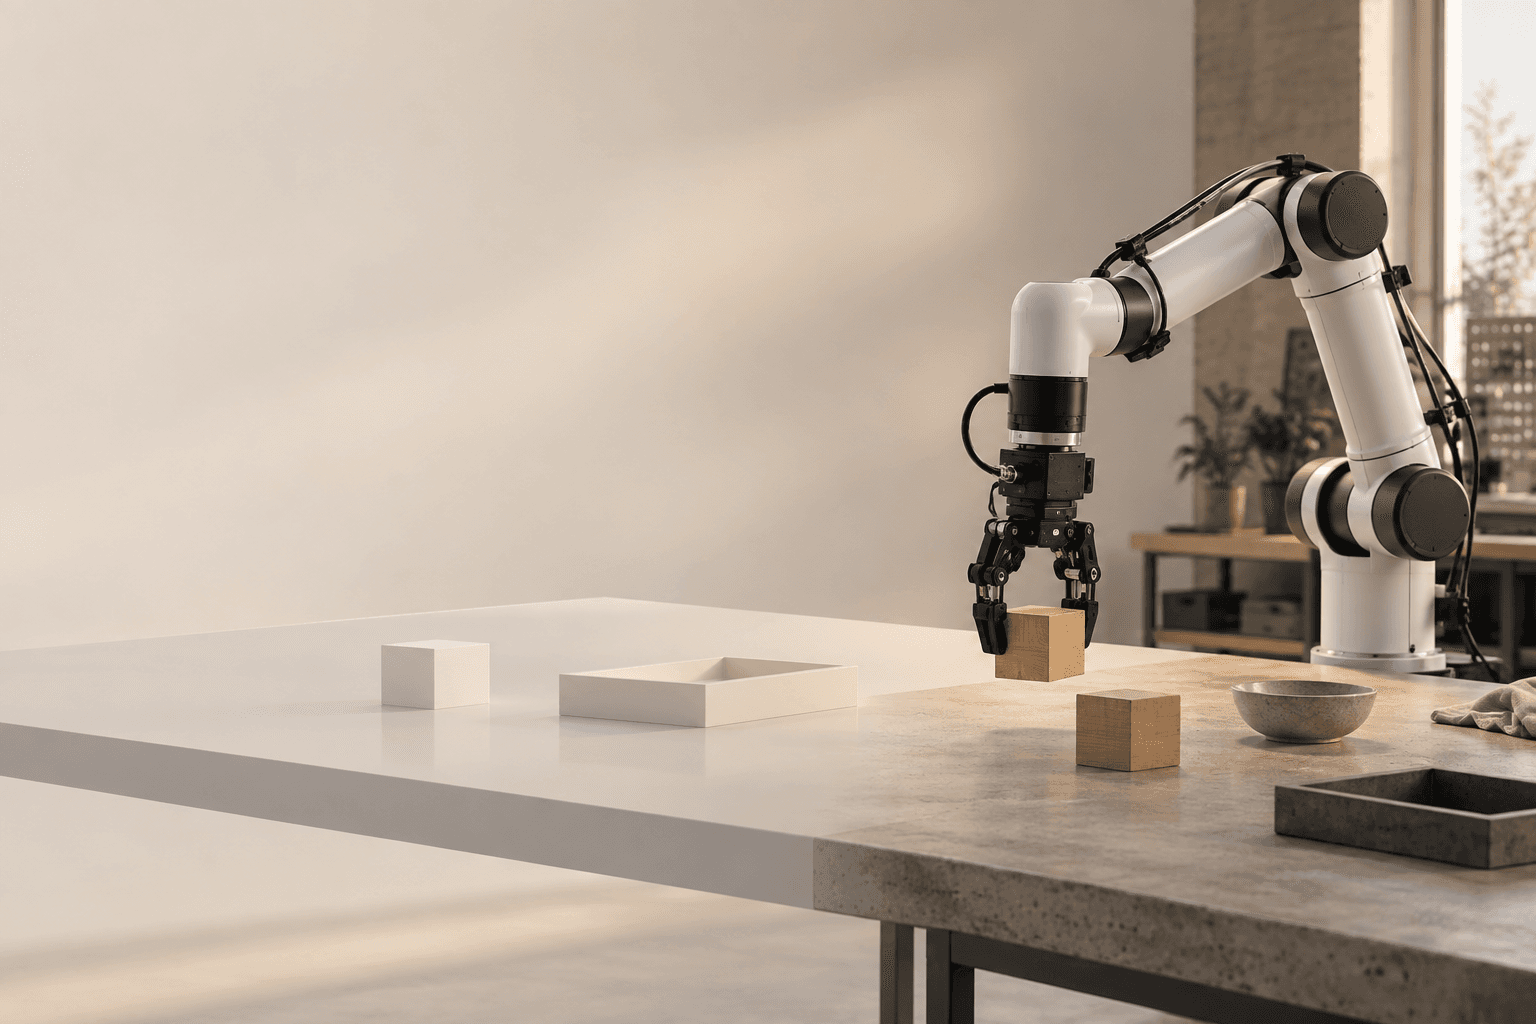
同一个机器人任务,在仿真环境与真实环境中可能面对完全不同的条件。传感、动力学、接触、时序、物体属性和具身形态都可能发生变化;Sim2Real 关注的是如何跨越并评估这种差距,而不是保证仿真中的成功会在硬件上自动复现。
Sim2Real 与相关术语的区别
机器人学习
机器人学习是从数据、示范、交互或仿真中获得或改进行为的更广泛领域。Sim2Real 是其中的迁移问题,可以出现在模仿、强化、监督式自适应或混合工作流中。
VLA
VLA 可以是迁移工作流中的一个组件,但不等同于 Sim2Real。要理解模型家族的边界,可以参阅什么是 VLA?。模型名称本身不能说明数据来自哪里,也不能说明是否展示了物理迁移。
数字孪生
数字孪生通常与特定物理资产保持关系,并可能支持监测、同步、预测、优化或决策支持。Sim2Real 可以使用不具备这些属性的仿真器,因此两者不应互换。
代表性研究例子
CAD2RL 展示了从合成训练到特定现实任务的视觉域迁移。动力学随机化研究说明改变物理参数如何支持有边界的真实机器人结果。Dactyl 和四足机器人运动研究则表明,迁移表现取决于身体形态、任务与评估设置。
这些是研究示范,不代表同一配方适用于所有机器人。MuJoCo 或 Isaac Sim 的工具页面可以说明仿真器能力,但它们本身不能证明策略已经迁移到真实机器人。
局限与开放问题
开放问题包括:选择能够反映目标条件的随机化范围,测量接触与延迟差异,在不安全探索的情况下收集有代表性的真实数据,在不破坏策略的前提下进行自适应,以及跨身体形态比较结果。长时程可靠性与失败报告,和成功率一样重要。
部署结论需要超过基准或短时实验室演示的证据。运行环境、可重复性、人工干预、安全边界、恢复行为、维护与时间范围,共同决定结果对持续使用的说明力度。
结论
Sim2Real 最适合被理解为建模世界与物理世界之间的迁移和证据问题。它可以放在具身智能的视角中理解,但仍不同于机器人学习、VLA 与数字孪生。域随机化、动力学随机化、标定、自适应和混合数据,是管理特定现实差距的工具;真实世界评估,才说明能力究竟迁移了多远。
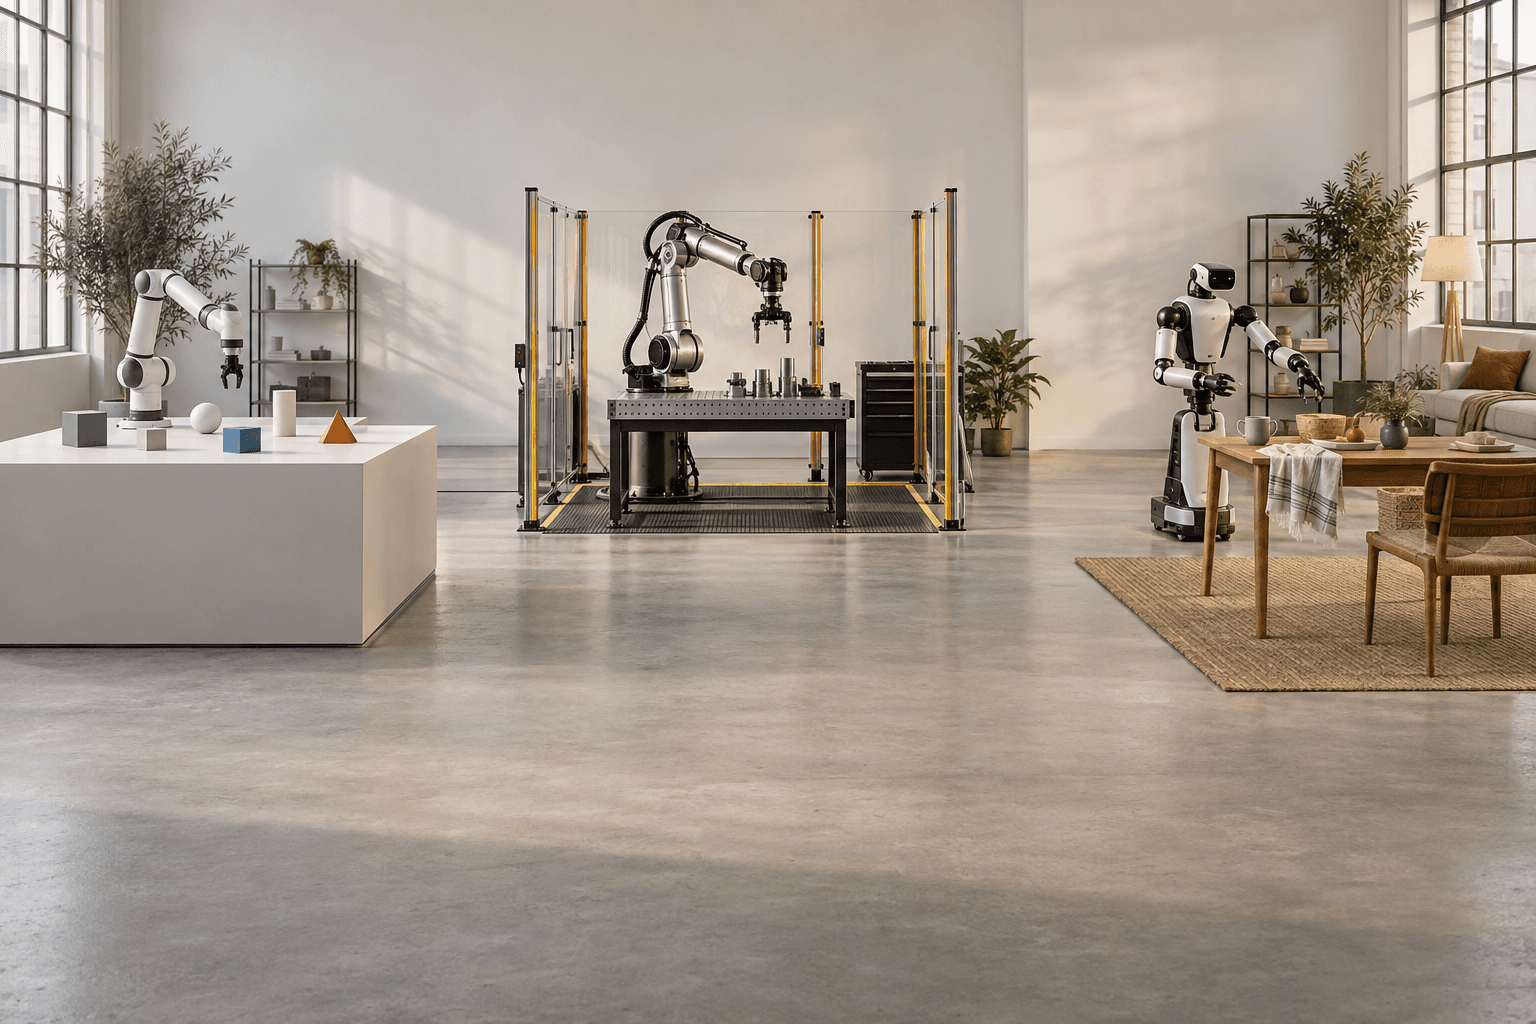
机器人能力可以在不同证据语境中被报告:仿真结果、受控硬件测试,以及重复的真实世界评估。这些是并置的证据语境,构成开放关系,不代表必经路线或成熟度排名。结论的可信度取决于任务、硬件、评估协议、失败情况,以及实际测试的范围。
这些锚点用于标示并置的证据语境,构成开放关系,不代表必经路线。
- 01仿真
- 02受控硬件测试
- 03真实世界评估